绕过无限debugger常规方法及复杂案例分析
记一次无限 debugger 的绕过实录:从被它卡死,到看穿它的递归
一、背景
做 Web 逆向,开发者工具是绕不开的。要读接口、要跟参数、要看加密逻辑,都得先进 DevTools。
但有这么一类平台,你一按 F12,它就开始跟你死磕——页面不停地在同一行停下来,你点“继续执行”,它立刻又在下一份“新文件”里停下来。这就是无限 debugger。
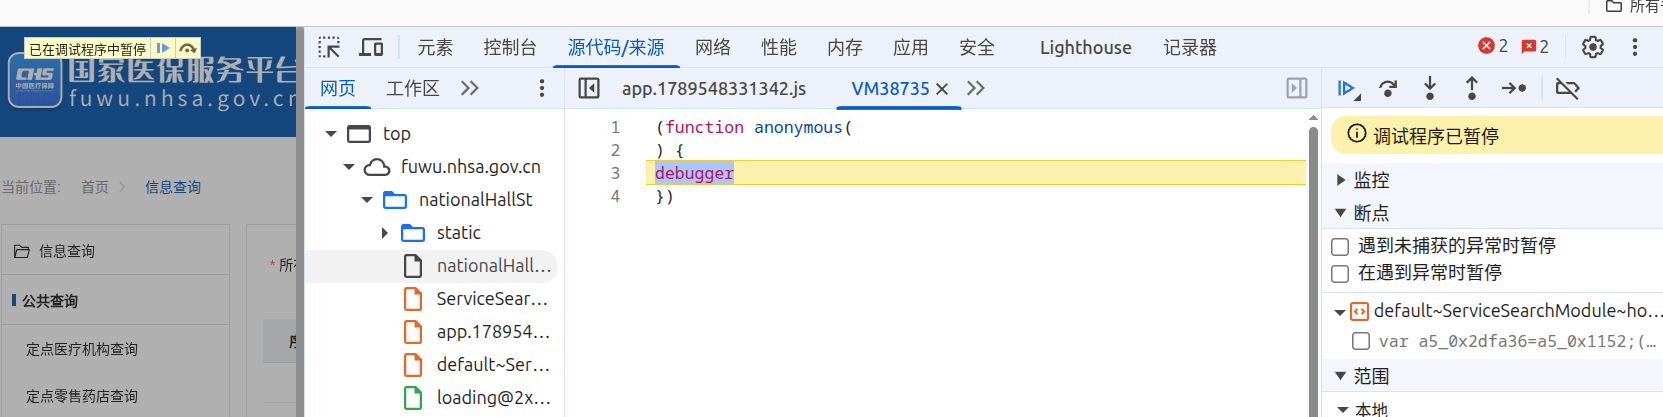
(上图这种,就是最典型的样子:点继续执行,它依旧卡在这儿。)
被它折腾过的人都懂那种感觉:明明只是想看一眼请求参数,结果浏览器卡成幻灯片,最后连页面都加载不出来了。
这篇文章我打算把这类防护彻底讲透:它有三种底层实现、常规有哪三种过法、以及我在一个真实政企平台上踩的全部坑——那个站点用的是最麻烦的一种,常规方法全军覆没。
二、无限 debugger 的三种底层实现
先把“敌人”认清楚。无限 debugger 的实现方式,基本跑不出下面三种。
第 1 种:setInterval 死循环
setInterval(function () {
debugger;
console.log("hello yuan")
}, 1000)
每 1 秒把 debugger 执行一次。你放行一次,1 秒后它又来。
第 2 种:setTimeout 递归
setTimeout(function foo (){
debugger;
console.log("hello world")
setTimeout(foo,1000)
},1000)
自己调自己,效果一样,只是写法换了个壳。
第 3 种:原型链 / 动态构造
// 还有一种
// 通过原型链的方式执行debugger
Function("debugger").call()
console.log("111")
Function("debugger").apply()
console.log("222")
Function.constructor("debugger").call("action")
console.log("333")
Function.constructor("debugger").apply("action")
console.log("444");
(function (){return!![]}["constructor"]("debugger")["call"]("action"))
console.log("555");
eval('(function (){return!![]}["constructor"]("debugger")["call"]("action"))')
console.log("666");
注意这第 3 种,它是后面所有麻烦的源头。
如果你在页面上看到“每次暂停都是一个不同的 VM 文件”,那基本可以断定:它是原型链 / 动态构造和定时器的混合产物。
三、顺手把两个定时器讲清楚
在看绕过方法之前,先把 setInterval 和 setTimeout 的行为掰开说——因为这里的坑,很多人(包括我)第一次都栽在这两个东西上。
// 定时器 setInterval(方法,间隔时间)
// 每间隔这个时间后再次执行这个方法
var ID = setInterval(function () {
console.log(("hello"));
},1000)
// 关闭定时器
clearInterval(ID);
// setTimeout(方法,间隔时间)
// 花费间隔时间后 执行一次方法就结束
var ID1 = setTimeout(function () {
console.log(("hello2"));
},1000);
// 关闭方法
clearInterval(ID1);
三个要点,划重点:
1. `setInterval` 会反复执行,`setTimeout` 只执行一次(想反复,得自己在回调里再调一次 setTimeout)。
2. 关闭定时器靠的是 `clearInterval(ID)`,那个 ID 是注册时返回的句柄——不是你后来覆盖 setInterval 这个函数就能取消的。
3. “注册”和“执行”是两件独立的事。setInterval(fn, 4000) 这一行跑完,只是“登记了一个 4 秒后要执行的任务”;真正执行 fn 是 4 秒以后。这一点在后面的排查里极其关键,我就是在这里差点判断错。
四、常规的三种绕过方法
4.1 第一种:一律不在此处暂停(最简单,也最脆)
在断下来的那一行左边右键,选“一律不在此处暂停”(Never pause here),然后继续执行,就能过去。
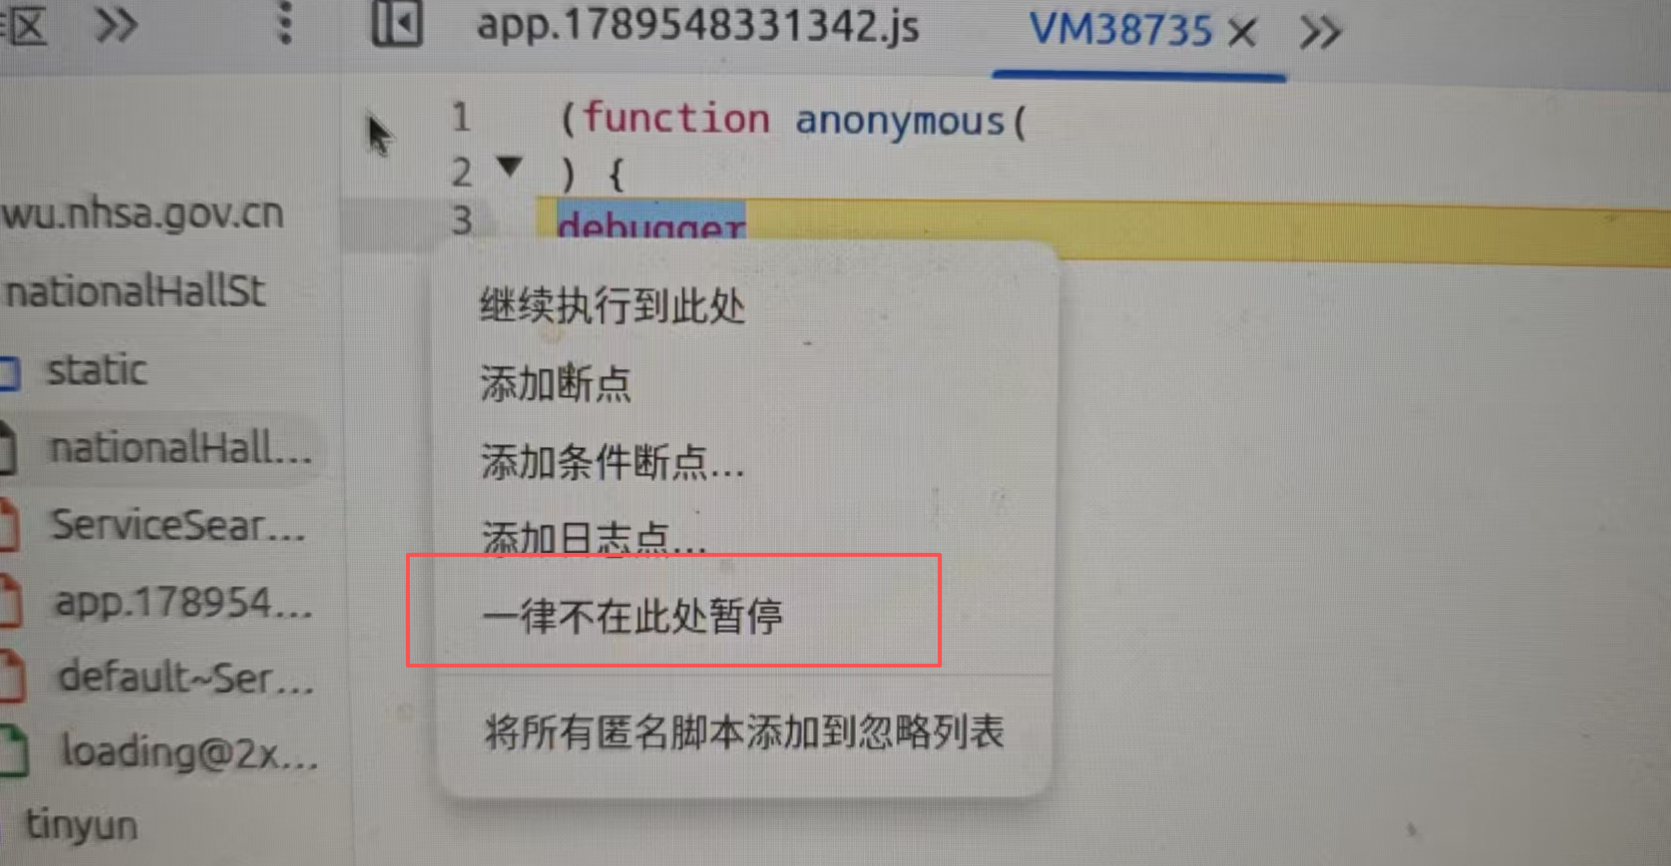
简单场景确实够用。但遇到复杂一点的就废了,而且会越用越卡,最后页面直接卡死。
为什么?因为“一律不在此处暂停”的实现,是在那一个位置(scriptId + 行号)挂一个永远为假的条件断点。而这个站点的每次暂停,都是一个全新 scriptId 的新脚本——你每点一次,只挡住了那一瞬间的那一份;下一份又是新位置,DevTools 只能不停给新脚本挂标记。脚本和标记越积越多,资源耗尽,页面就死了。
这个坑我在下面讲的那个案例里也结结实实撞了一次。
4.2 第二种:Hook(核心方法)
稍微复杂的场景,就得靠 Hook。
思路是:在断下来的地方,看右侧的调用栈,找到定时器函数那一层,然后在它执行之前,把这个函数覆盖掉。
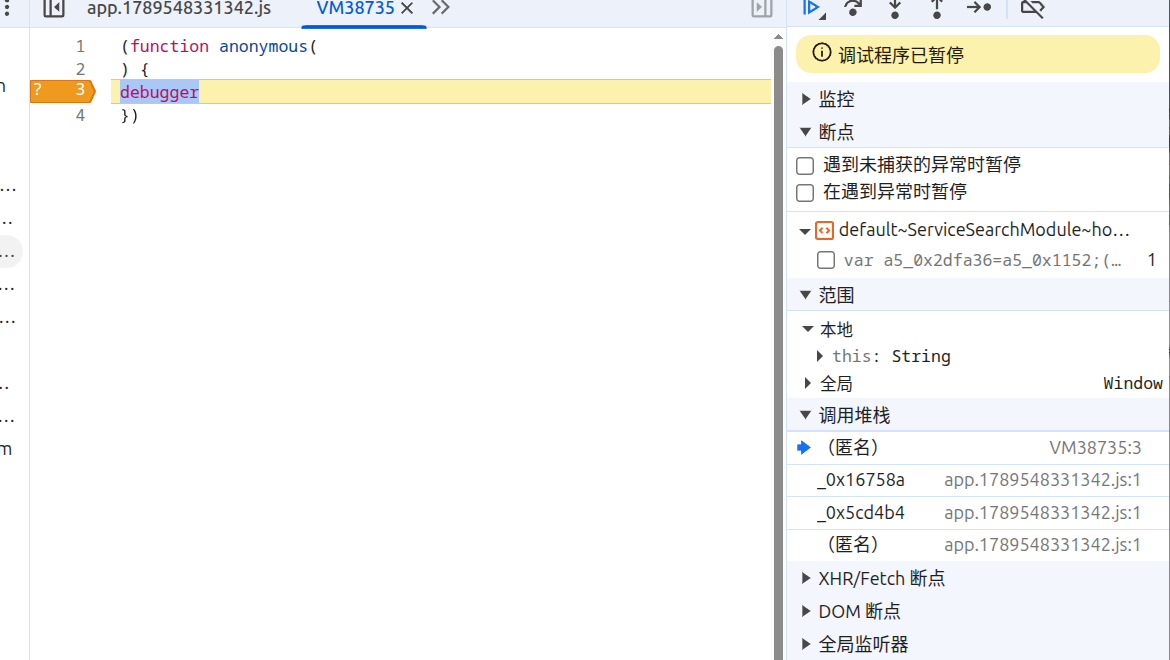
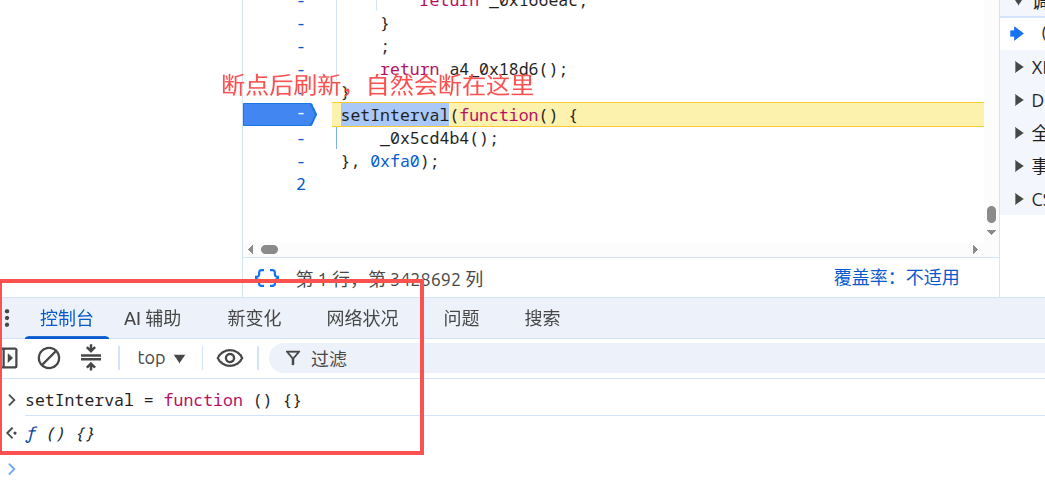
然后在控制台输入:
setInterval = function () {}
回车,再继续执行脚本。大部分情况到这一步就绕过去了。
这招对付“第 1 种、第 2 种”那种老老实实用定时器的无限 debugger,非常好用。 但请记住它的前提:它能生效,是因为那些 debugger 真的靠定时器活着。
4.3 第三种:文件替换(本地覆盖)
这招其实很简单:事先准备一个空文件夹,在 Sources 的 Overrides(替换)里把它设为替换目录;比如我建的那个文件夹叫 app。
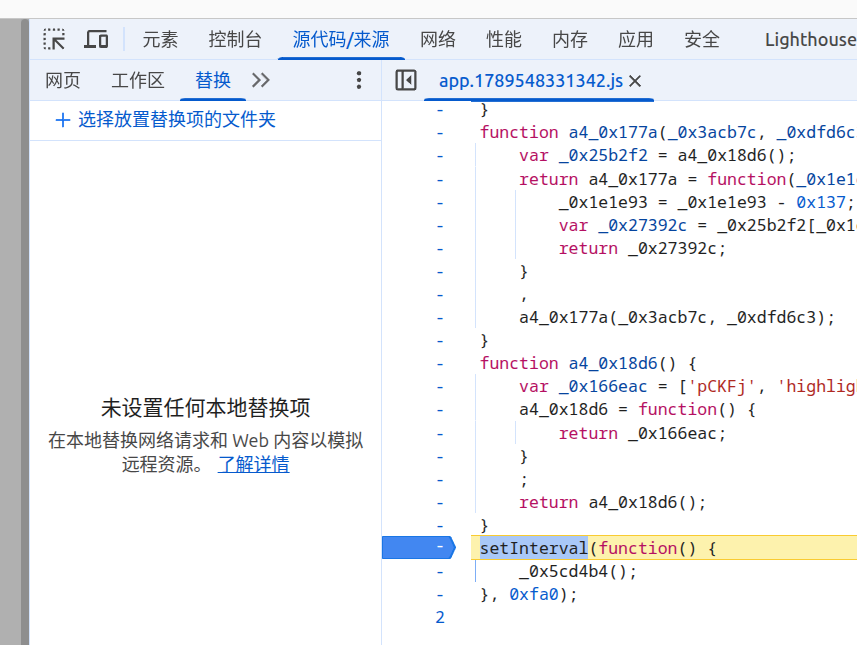
设好之后,去原本那个定时器所在的 js 文件上右键,点“替换内容”。
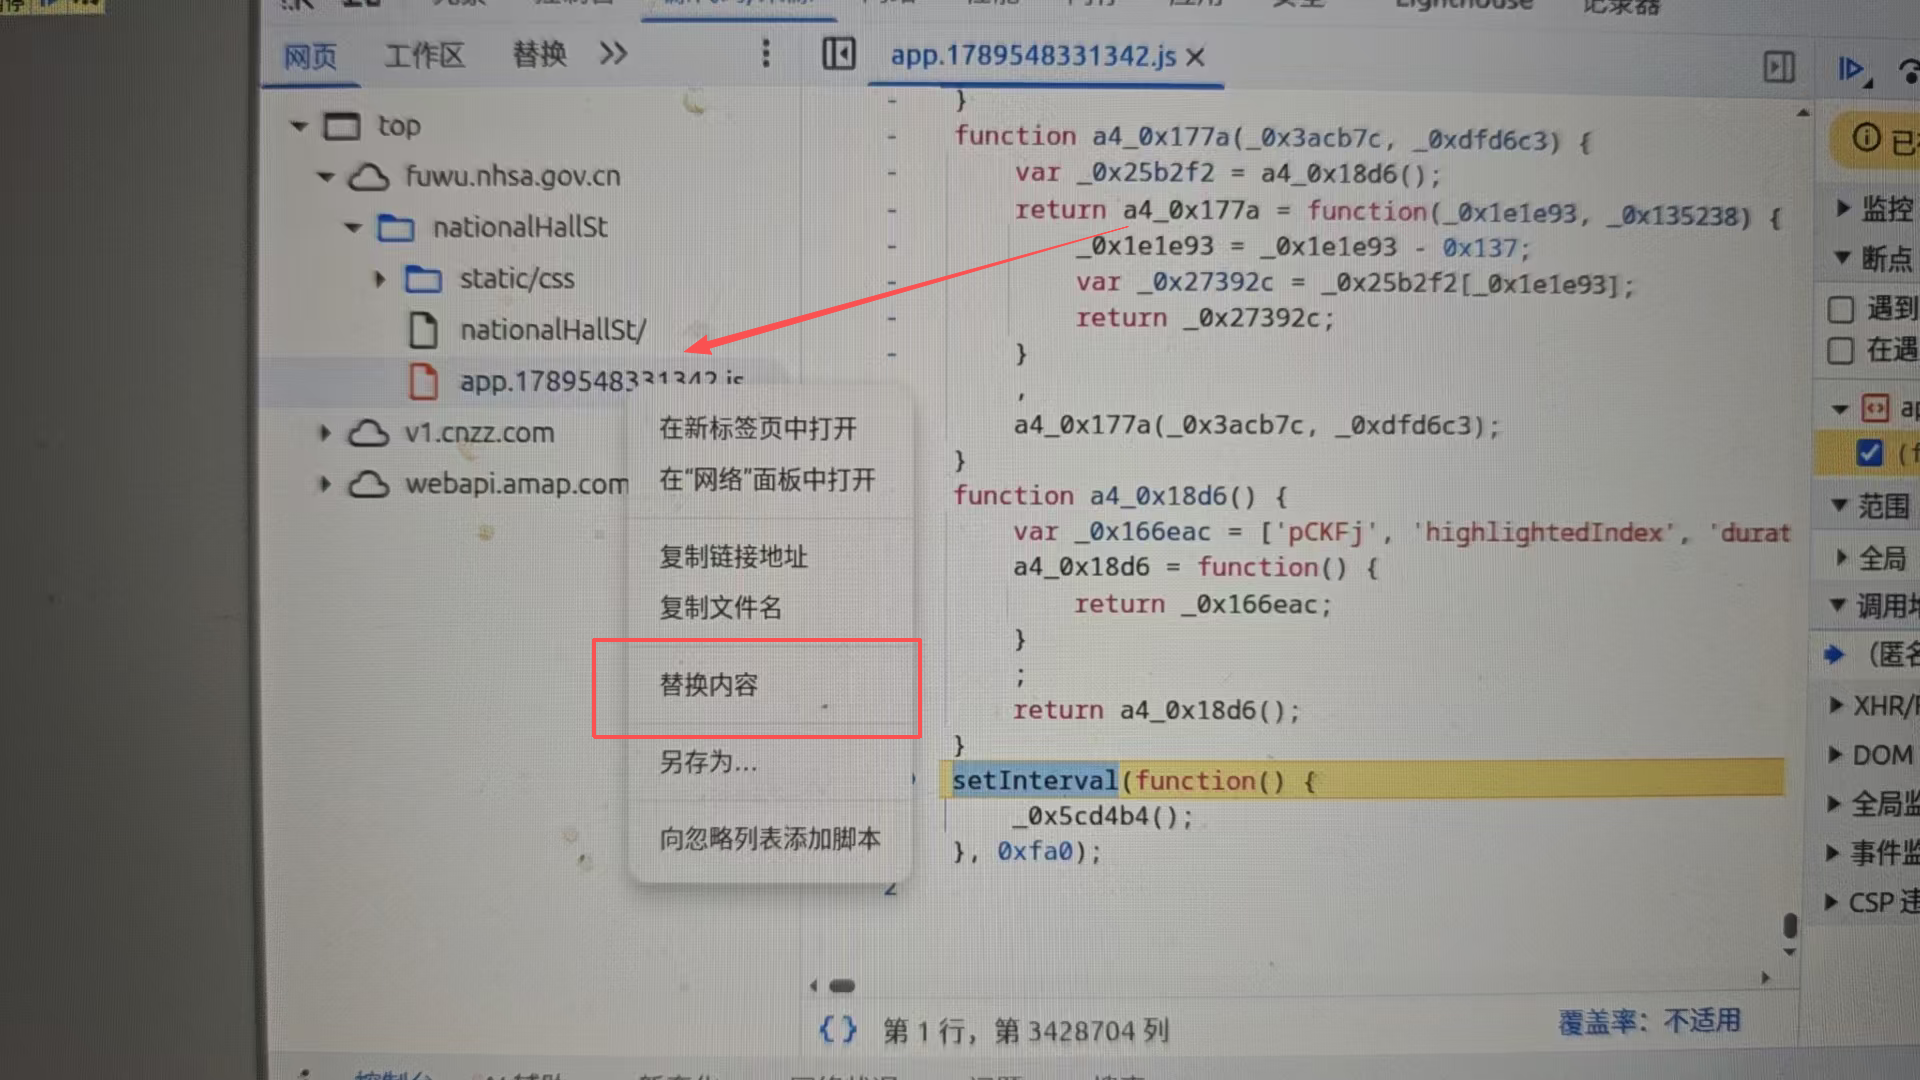
接着就能在本地那份替换文件里随意改代码了——直接把 debugger 那几个字注释掉或者删掉就行。
两个细节别忘:
• 改完一定要保存(Ctrl+S),不然不生效;
• 有时候你在源码里根本看不到定时器里那个 `debugger`——因为它被混淆了。这时候就得先做代码分析,别硬盯。
4.4 小结
以上是三种常规方法。但在真实战场上,遇到复杂的 debugger,能指望的基本只有第二种(Hook);而且它的 debugger 很可能是用混淆后拼接出来的原型链方式构造的,那就完全是另一个难度了。
下面就是那个“另一个难度”的真实案例。
五、真实案例:某政企平台
URL:
https://fuwu.nhsa.gov.cn/nationalHallSt/#/search/agency-inquiry?code=174000&message=serverUrl%20is%20null&gbFlag=true
可以自行访问试试。
先说结论,省得你走我的弯路:上面三种方法我全试了一遍,一个都没过。
• “一律不在此处暂停”——不但没用,还越点越卡,最后页面直接卡死;
• 控制台 setInterval = function () {}——照样一层一层往下断;
• 取消断点(停用断点)——不但没用,还会卡死。
而且它的行为特别气人:你每执行一次,它就跳到下一个 VM 文件里去断,而且每次的文件都不一样。
5.1 现场:它的 debugger 长什么样
先看调用栈,一眼就能看出这里做了混淆:
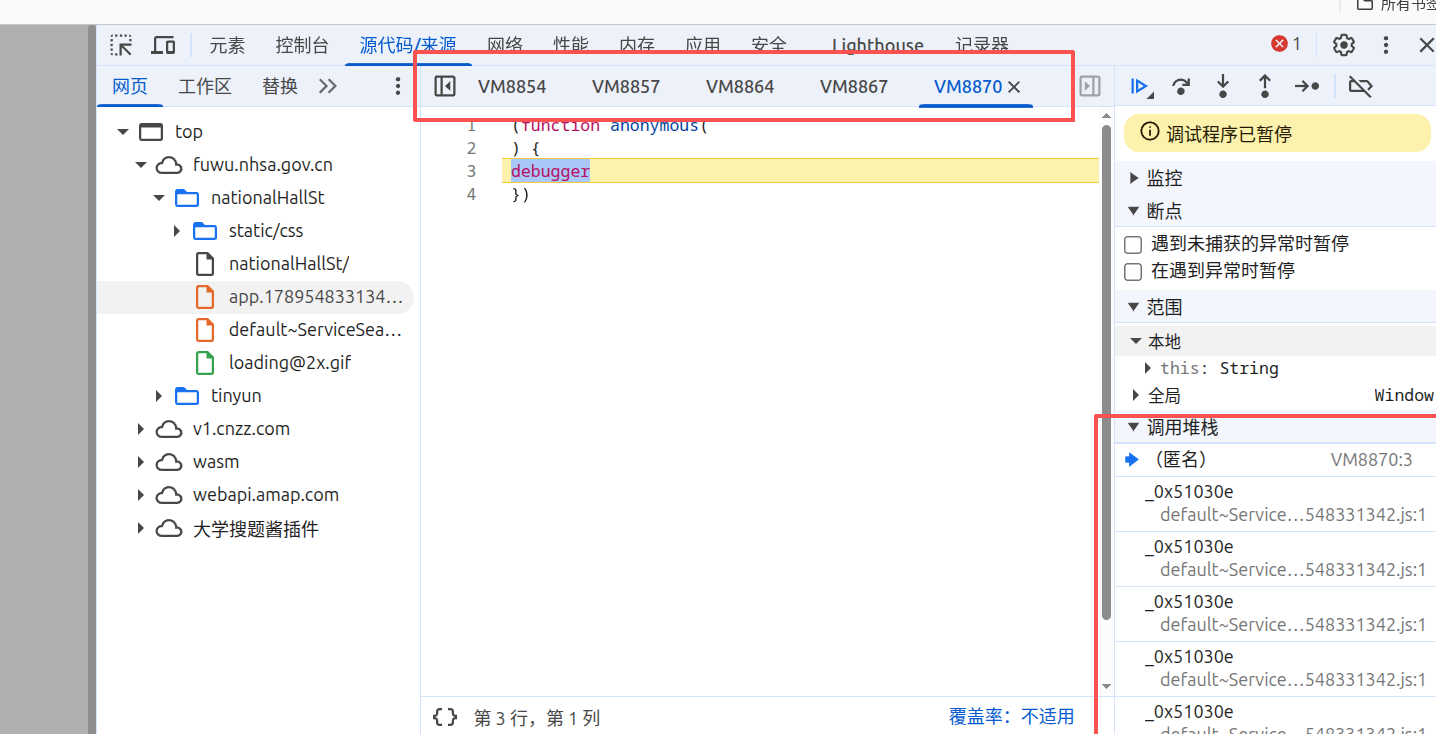
而它每次断下来的那个脚本,内容居然只有这么点东西:
(function anonymous(
) {
debugger
})
`anonymous` + 空 URL + 每次新建 VM 文件——这三个特征凑在一起,答案就只剩一个了:`Function(“debugger”)` 动态构造。
5.2 为什么能这么断定(推理过程)
这里我不想直接甩结论,把推理过程写出来,因为这个推理套路是可以复用的。
证据一:`function anonymous(` 这层壳,不是人写的。
它是 V8 的 `Function` 构造器自己拼出来的——构造器会把参数列表塞进 anonymous() 那个括号里,把函数体塞进花括号里。
对比一下就很清楚:如果这段代码是网络加载来的,你会看到 app.1789548331342.js 这种真实文件,里面是密密麻麻的压缩代码,绝不会出现 `anonymous` 这种脚手架。
所以:这层壳 = 这段代码是被“编译”出来的,而且编译入口就是 `Function` 构造器。
证据二:脚本 URL 是空的。
有 URL,说明这个脚本是下载/内联来的,它有来源;
URL 是空的,说明它没有来源文件,是在内存里现编的。
而“现编”在浏览器里总共就两条路:eval 和 Function(外加 setTimeout('字符串') 这种早就淘汰的写法)。再结合证据一那层壳,只剩 `Function`。
证据三:每次暂停都是一个全新的脚本,从不重复。
推理很简单:如果 debugger 是源码里写死的,那它永远是同一个 scriptId、同一个行号,你断一千次也是同一个地方。
但这里每次都是新的,说明这段代码在被反复重新编译。而“反复编译”这件事,必须由一段会循环或递归的代码来驱动——每循环一次,就重新编译一份 Function('debugger')。
证据四(反证法):如果真是在源码里写死了 `debugger`,你会看到什么?
• scriptId、行号固定不变;
• 能正常用“下一行执行”(Step over)走过去;
• 调用栈短,而且没有重复帧;
• 脚本 URL 不为空。
上面四条,和现场观察全部相反。所以“源码写死”这个可能,被排除得干干净净。
5.3 从调用栈看出它是递归
还有一个特别直观的证据——看栈。
你每点一次“继续执行”,_0x51030e 这个混淆函数就会在栈里多出现一次;而 a5_0x603cc0 就是进入递归的那个入口。
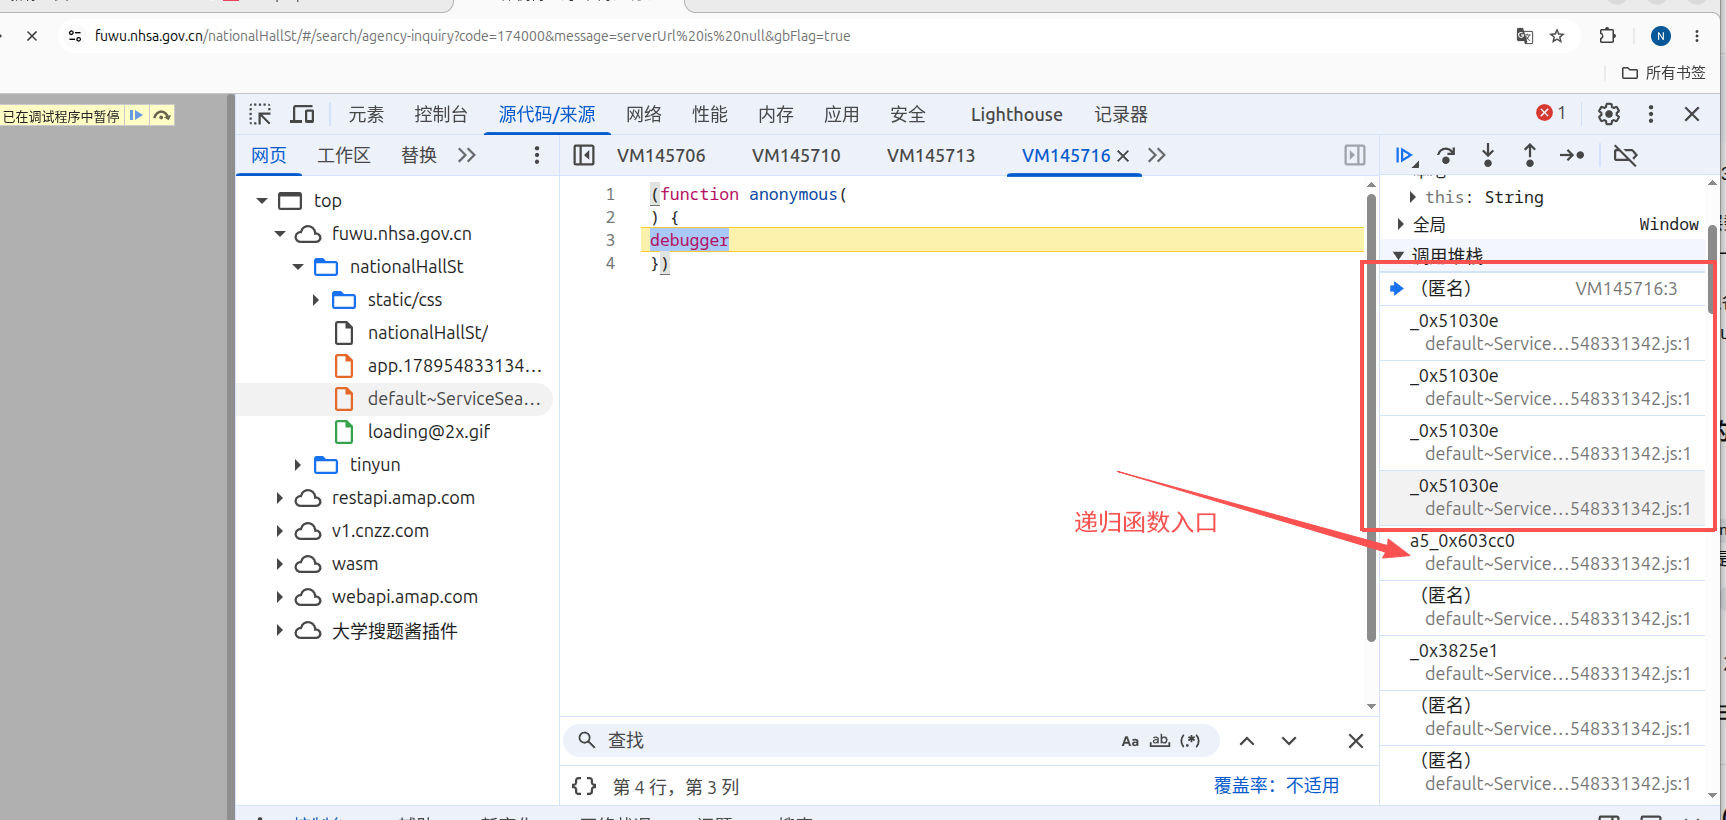
规律很清楚:
• 同一个函数名重复出现 = 递归;
• 重复层数随暂停次数同步增长 = 每放行一次,递归就深入一层。
这也顺手解释了那个最让人困惑的问题——“为什么每次都是新 VM 文件”:递归每深入一层,就调用一次编译入口,于是又生成一份新脚本。
所以:暂停发生在一个“空 URL、每次新建、源码是 (function anonymous(){debugger})”的脚本里,已经证明了有人调用了 `Function(“debugger”)`。
剩下的问题只有一个:是谁调的? 答案就在栈里——`_0x51030e`。
5.4 跟着栈名去看递归的规则
刷新页面重新触发,观察它的调用规则。
第一次:断在函数定义处,此时传进去的 _0x3428df 是 0。
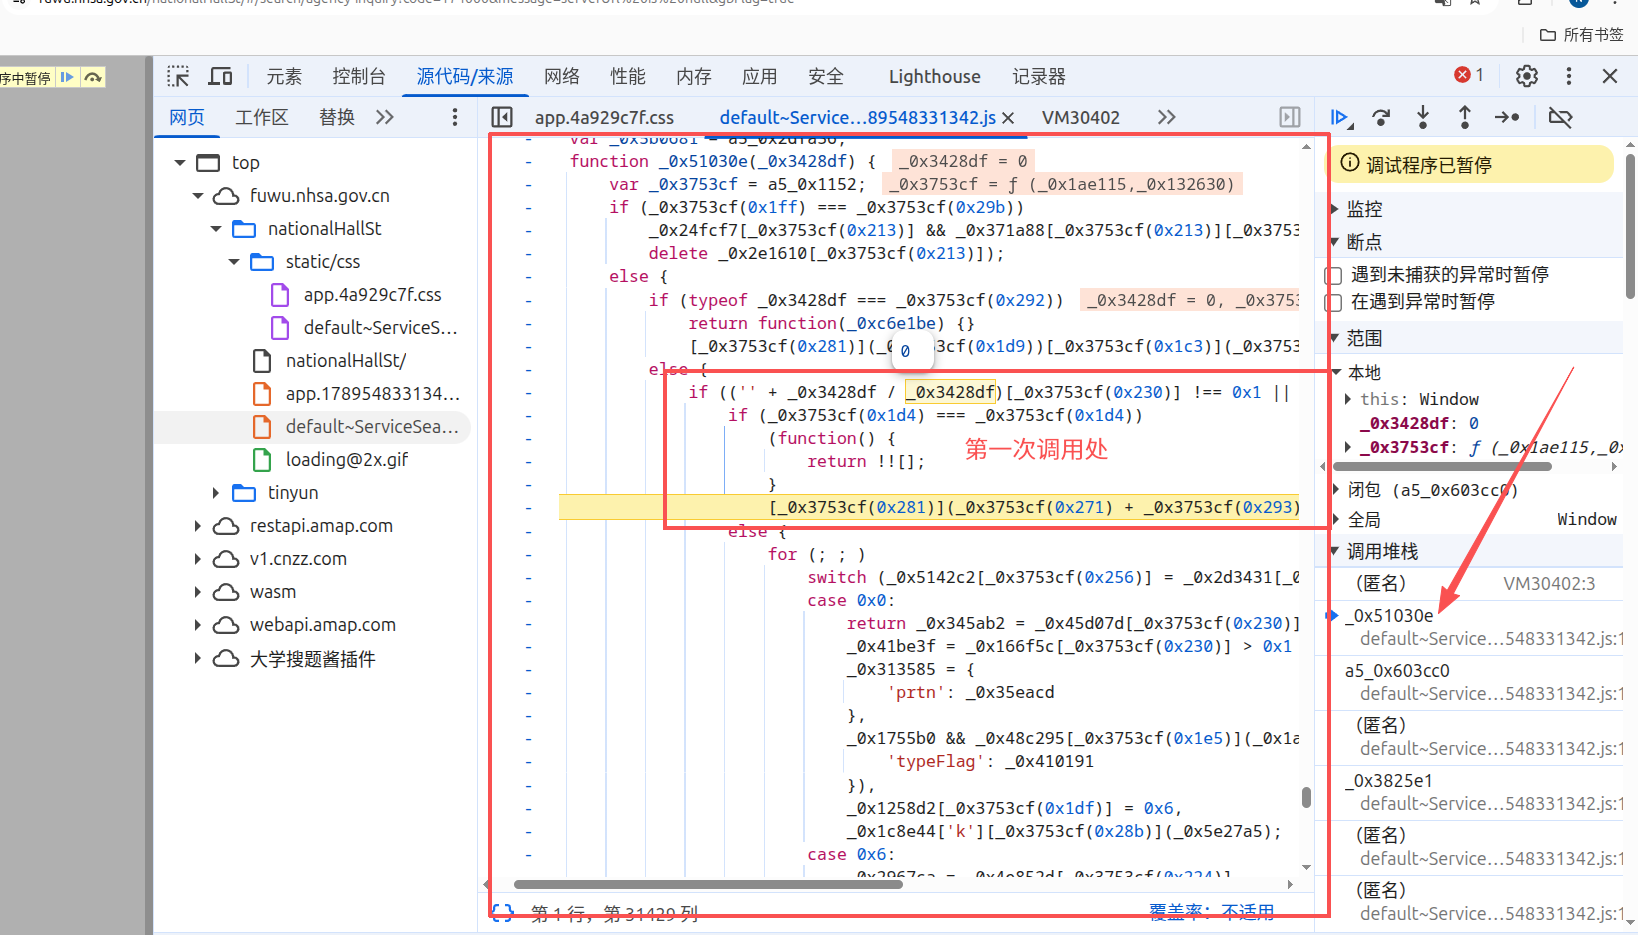
第二次继续执行后:发现跳到了原函数下面的 else 分支,同时 _0x3428df 变成了 1。
再点继续执行:跳到 _0x51030e(++_0x3428df); —— 这就是递归那一句。每执行一次,_0x3428df 自增 1,_0x51030e 又被调用一次。
不管断在哪一层,断点前那一句函数体都是这样的:
(function() {
return ![];
}
[_0x3753cf(0x281)](_0x3753cf(0x271) + _0x3753cf(0x293))[_0x3753cf(0x1c3)](_0x3753cf(0x22f)));
看着乌漆嘛黑,但结构上和我们前面讲的那句原型链一模一样:
(function (){return!![]}["constructor"]("debugger")["call"]("action"))
为了不把篇幅拖长,我当时没进 _0x3753cf 内部去解混淆,但结果是可以确认的:它就是 `(function (){return!![]}[“constructor”](“debugger”)[“call”](“action”))`。
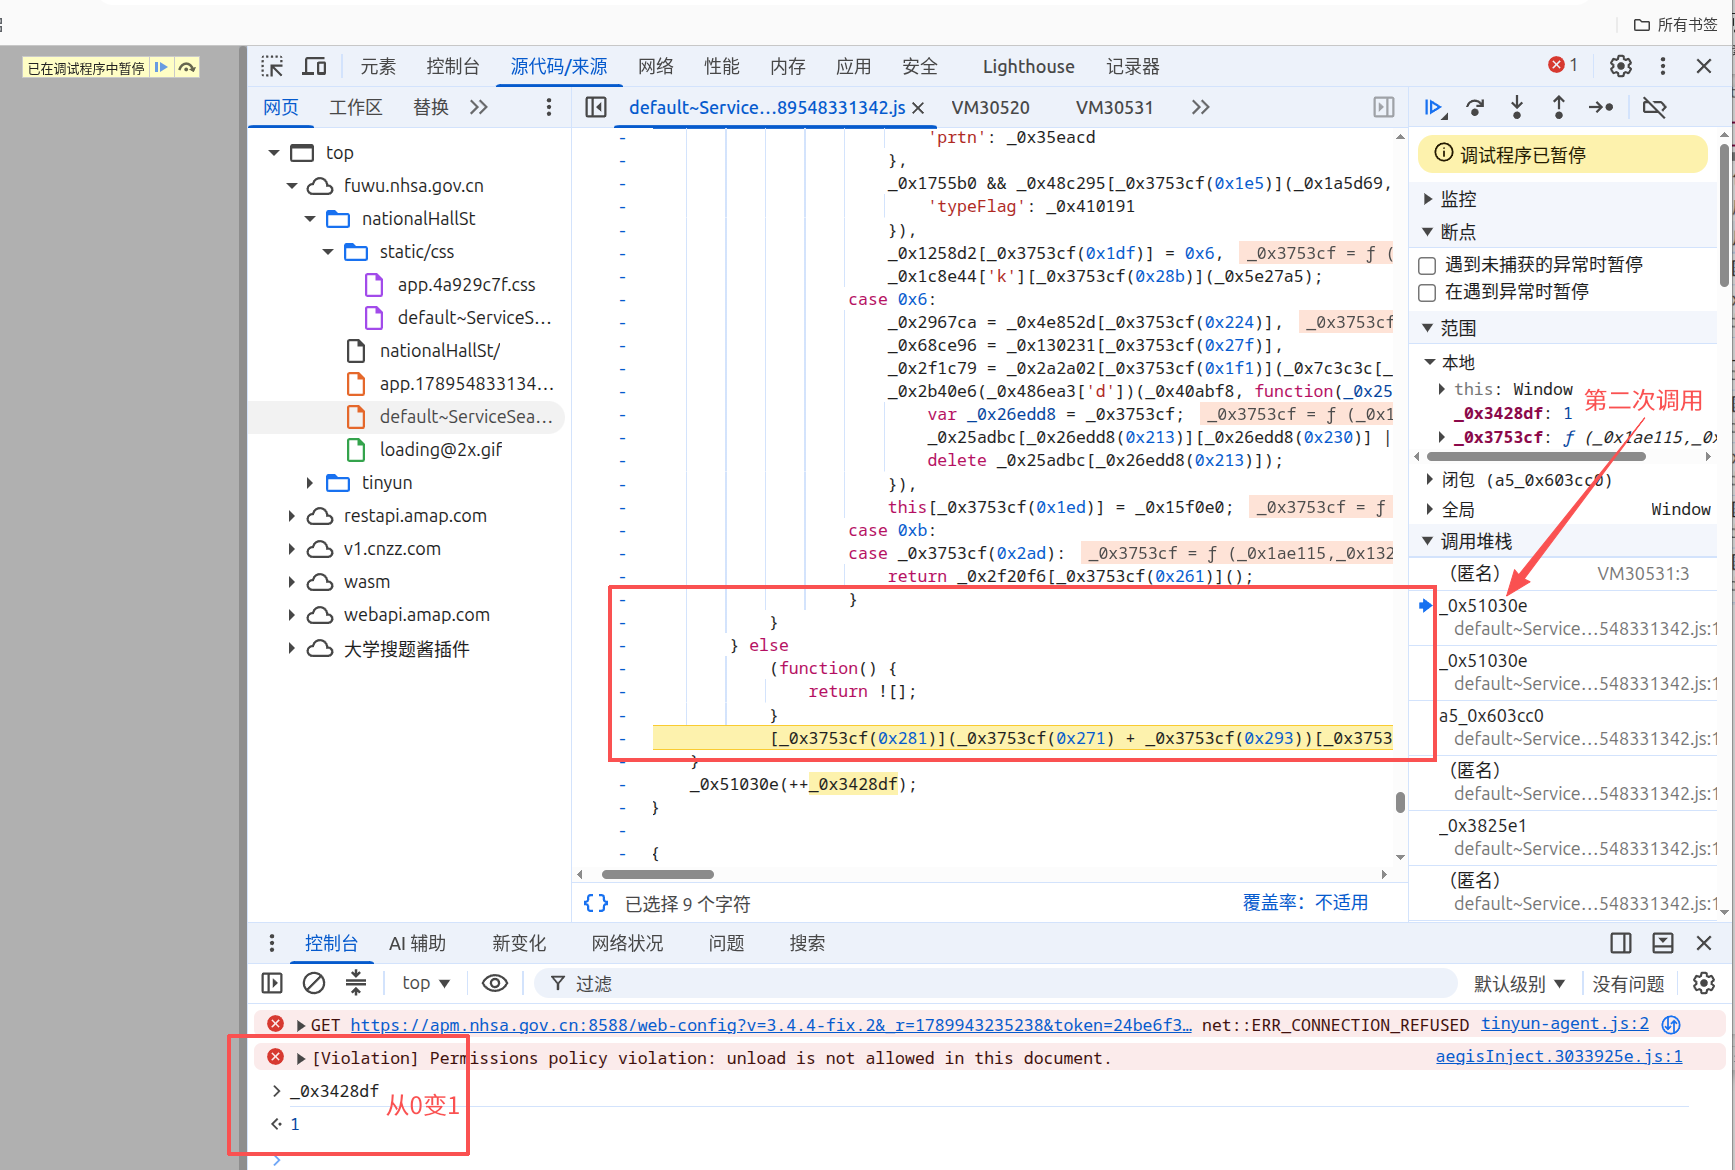
这一步其实应该解开的(后面第六节我会补上完整解法,比当时“跳过”要干净得多)。
5.5 回到定时器:两处断点,和那个让我差点判断错的时序
debugger 的执行函数虽然已经是递归了,但它最开始还是依托定时器被拉起来的,所以排查的第一步,还是全局搜索关键字:
setInterval(function()
找到了两个地方,给这两处都打上断点,刷新:
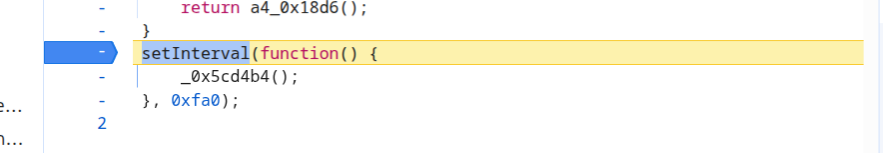
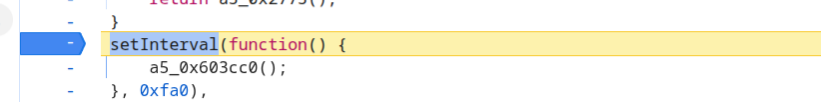
第一次断在第一个,继续执行后在第二个断点断下,再执行就是 debugger 了。
到这一步,很容易得出一个错误结论:“这个 debugger 是定时器每 4 秒拉起来的。”
我一开始也是这么以为的,然后就被打脸了。
因为这里有个细节特别容易被忽略:`setInterval(function(){...}, 4000)` 这一行,是“登记”,不是“执行”。 我断在那一行,只是断在“登记任务”这个动作上;真正执行回调,要等 4 秒以后。
也就是说:如果我在那一行继续执行后“立刻”就撞上了 debugger,那这个 debugger 根本不可能来自这个定时器——时间对不上。
后来实测数据也印证了这一点(第七节会给完整数据):页面加载后 1 秒内就断了 152 次,而定时器第一次响是 4 秒。定时器还没响过一声,断点就爆了 152 次——凶手不可能是它。
真要一锤定音,就在进入 debugger 的瞬间看一眼调用栈的栈底:
• 栈底是几层 (anonymous) 的初始化代码、中间是 a5_0x603cc0 → 加载时那条路;
• 栈底是定时器回调 → 定时器那条路。
我实测抓到的栈是这样的:
(anonymous) ← 刚编译出来的那份 debugger
_0x51030e × 100 ← 递归本体
a5_0x603cc0 ← 进入递归的入口
(anonymous) × 4 ← 初始化代码,栈底
栈底那几层里,压根没有定时器回调。
六、把混淆代码还原成人话
到这儿,我们已经知道“谁在编译 debugger”了。接下来把那段混淆代码彻底解开——这一步做完,你会觉得它其实一点都不神秘。
6.1 两份函数,其实是同一个模板的两个副本
上面在 app.js 和路由分包里抓到的两段代码(_0x5cd4b4 和 a5_0x603cc0),看着八竿子打不着,其实结构完全一样,只是被各自混淆成了不同的名字:
对比项 |
第一份(app.js 主包) |
第二份(路由分包) |
取值函数 |
a4_0x177a |
a5_0x1152 |
内部递归函数 |
_0x16758a |
_0x51030e |
递归语句 |
_0x16758a(++_0x30c7f8) |
_0x51030e(++_0x3428df) |
字符串分支 |
typeof x === 'string' |
typeof x === 'string' |
debugger 分支 |
!![] / ![] 两支 |
!![] / ![] 两支 |
入口总闸 |
if (arg) return _0x16758a; else _0x16758a(0) |
if (arg) return _0x51030e; else _0x51030e(0) |
这解释了一个很常见的困惑:你在调用栈里看到 `_0x51030e`,去全局搜索,却在 `app.js` 里搜不到。 因为它属于另一个分包。webpack 打包时每个 chunk 各自混淆一次,同一个逻辑会有多份,函数名各不相同。
所以:按栈里看到的函数名去搜索,一定能搜到它所属的那份文件。 这就是“跟着栈名走”比“凭感觉猜名字”可靠得多的原因。
6.2 解混淆:把 `_0x3753cf(0x281)` 变成 `'constructor'`
先看那句关键代码:
(function() { return ![]; }
)[_0x3753cf(0x281)](_0x3753cf(0x271) + _0x3753cf(0x293)
)[_0x3753cf(0x1c3)](_0x3753cf(0x22f));
第一步,把“取值函数调用”挖掉,只看语法骨架:
(function(){...}) [ 属性 ]( 参数1 ) [ 属性 ]( 参数2 )
这就是最普通的 JS 链式调用:取属性 → 调用 → 取属性 → 调用。混淆只换了名字,语法结构一点没动。
第二步,搞清 `_0x3753cf` 是什么。
它是取值函数,长这样:
function a5_0x1152(n) {
var arr = a5_0x1152_array(); // ① 所有字符串都塞在一个大数组里
a5_0x1152 = function(i) { // ② 把自己替换成更快的版本(缓存)
return arr[i - 0x134]; // ③ 统一偏移 0x134
};
return a5_0x1152(n);
}
它不是加密,是查表。 每个 0x281 这样的下标,减掉偏移 0x134,就是数组下标,取出来就是一个普通字符串。它还有副作用:第一次调用时构建字符串数组,并把自己替换掉。
第三步,别读代码,让代码自己报答案。
在断点暂停的状态下(这时控制台的作用域链就在这个函数里),粘贴:
// 批量解密:把这段代码用到的下标一次全解出来
[0x292,0x281,0x271,0x293,0x1c3,0x22f,0x21d,0x294].map(function(k){
return '0x' + k.toString(16) + ' -> ' + _0x3753cf(k);
});
为什么必须在“暂停状态”下执行? 因为取值函数是函数的局部变量,页面正常跑的时候你在全局根本访问不到它,会直接报 not defined。只有在断点暂停时,控制台的作用域链才包含它。这是这类“字符串数组混淆”的通用访问姿势,记住能省很多事。
输出大概长这样:
0x292 -> 'string'
0x281 -> 'constructor'
0x271 -> 'debu'
0x293 -> 'gger'
0x1c3 -> 'call'
0x22f -> 'action'
0x21d -> 'apply'
第四步,代入:
(function(){ return ![]; })["constructor"]("debu" + "gger")["call"]("action")
合并拼接,得到:
(function(){ return ![]; })["constructor"]("debugger")["call"]("action")
翻译成最直观的写法,就是:
Function("debugger")("action")
到这一步,混淆就被剥干净了。
6.3 每一部分为什么要这么写
写法 |
真实作用 |
为什么要写成这样 |
(function(){return ![];}) |
随便一个函数字面量,只为有个对象能取属性 |
躲开 Function( 的静态搜索 |
[“constructor”] |
取到 Function(任何函数的 constructor 都是 Function) |
躲开关键词 Function |
“debu” + “gger” |
运行时拼成 'debugger' |
躲开关键词 debugger |
[“call”](“action”) |
立即执行刚编译出来的函数 |
让 debugger 真的被执行到 |
一句话:整句的语义就是 `Function(“debugger”)(“action”)` —— 编译一段含 `debugger` 的代码,并立刻执行它。
6.4 还原后的完整“人话版”递归函数
两份模板剥掉混淆后,完全等同于下面这段:
function debugProtection(arg) {
function recurse(n) {
if (typeof n === 'string') {
// 传字符串进来:只把“能触发 debugger 的函数”交出去,不执行
return function(){}.constructor('debugger').call('action');
}
// 数字分支:每层都编译并执行一份新的 debugger
if (('' + n / n)['length'] !== 1 || n % 0x14 === 0) { // 也就是 n % 20 === 0
(function(){ return ![]; }).constructor('debu' + 'gger').call('action');
} else {
(function(){ return ![]; }).constructor('debu' + 'gger').call('action');
}
recurse(++n); // ← 递归:再深一层,每层一个新 debugger
}
try {
if (arg) return recurse; // 传参 → 只把函数交出去,不跑
else recurse(0); // 不传参 → 立刻开跑 ← 无限 debugger 的起点
} catch (e) {} // 栈溢出被吃掉 → 永远不会“自己停”
}
6.5 三个关键设计
看懂这三个,这类防护就彻底看懂了。
关键设计 1:入口有个“总闸”——传参和不传参,是两副面孔
try {
if (arg) return recurse; // 传参:只把递归函数“交出去”
else recurse(0); // 不传参:立刻开跑
} catch (e) {}
• 传参(比如 a5_0x603cc0('0')):只是把内部递归函数返回出去,让外层的“自校验代码”拿它的 toString 去做正则比对,本身不触发 debugger;
• 不传参(比如 a5_0x603cc0()):立刻执行 `recurse(0)`,无限 debugger 从这里开始。
我们搜到的那两个 setInterval 回调,都是“不传参”那一档。所以定时器一响,递归就开一轮。
关键设计 2:递归是“自调用”,跟定时器没关系
recurse(++n);
这一句是普通的函数自调用,不是 setTimeout、也不是 setInterval。它在你点“继续执行”的瞬间,就往下走了一层。
这就是“继续执行 = 深入一层”的根本原因,也是“掐定时器没用”的根本原因——正在跑的这一轮,根本不需要定时器。
关键设计 3:`try/catch` 把栈溢出吃掉了
递归几千层之后,V8 会抛 RangeError(栈溢出),但被 catch (e) {} 静默吞掉了。
所以它不会崩、不会报错、也不会自己停——只会安静地结束这一轮,然后等 4 秒后由定时器再来一轮。
这就是“无限”的真相:它不是真的无限,而是“每次快撑爆的时候,就被重启一次”。
6.6 混淆里的“噪音”怎么识别
混淆器会塞大量对功能毫无影响的代码,专门浪费你的时间。识别标准只有一条:
两支分支的行为,对观测结果有没有区别?没有区别,就是噪音。
噪音 1:自己跟自己比,永远为真
if (_0x3753cf(0x1d4) === _0x3753cf(0x1d4)) // 同一个取值函数、同一个参数 → 恒真
噪音 2:双胞胎分支,功能完全等价
if (('' + n / n)['length'] !== 1 || n % 0x14 === 0x0) {
(function(){ return !![]; }).constructor('debugger')... // 真支
} else {
(function(){ return ![]; }).constructor('debugger')... // 假支
}
• ('' + n/n)['length'] !== 1 恒为 false;
• 真正起作用的是 n % 0x14 === 0x0,也就是每 20 层走一次真支,其余 19 层走假支;
• 但两支都在调 `Function('debugger')`,行为完全等价。 !![] 和 ![] 只是两件颜色不同的同款衣服。
这顺手解释了一个现象:你按一次“继续执行”,下一层因为 n 变了,会落进另一个分支,于是相邻两次断点的行号会在两个分支之间来回跳。你以为是“跳到别处去了”,其实只是同一个函数的下一层换了件衣服。
读到这类代码,直接跳过,别试图理解它的“业务含义”——它没有业务含义。
七、为什么常规方法在这里全部失效(附实测数据)
先说一个最基础、但最容易被忽略的概念:
`debugger` 是“代码找调试器”,断点是“调试器找你”——这是两套完全独立的机制。
• 你在源码某一行下断点:是你做了个标记,执行到那里时调试器停下 → 调试器找你;
• 代码执行到 debugger 语句:是代码主动通知调试器停 → 代码找调试器。
“取消断点”“忽略列表”这些开关,关的全是第一套,所以对 debugger 语句没有任何影响。
顺带一个反证:你不开 DevTools 的时候,那几百次 `debugger` 一次都不会停——因为没有调试器挂着时,debugger 就是空操作。这也说明这类防护从头到尾只针对开发者,普通用户完全无感。
下面是我在 Chrome 152 上实测的数据(每个实验独立标签页,“自动继续执行”模式):
手段 |
前 1 秒内暂停 |
之后 10 秒暂停 |
不同 scriptId |
空 URL 脚本 |
基线,什么都不做 |
152 |
436 |
436 |
437 |
在 1 秒时把 setInterval 赋空函数(≈第二种方法的做法) |
154 |
437 |
437 |
439 |
开“停用断点”(setSkipAllPauses) |
— |
401+(打满采样上限,与基线一致) |
— |
— |
忽略列表 / blackbox 全部脚本 |
— |
401+(同样毫无变化) |
— |
— |
在加载前清洗 Function(正确解法) |
0 |
0(15 秒内) |
0 |
2 |
逐条解释:
(1)“一律不在此处暂停”为什么越点越卡?
前面说过:它是在“某个 scriptId + 某行号”上挂一个永假条件断点。而这里每次暂停都是全新 scriptId 的新脚本,你每点一次只挡住了那一瞬间的一份,下一份又是新位置——DevTools 只能不停给新脚本挂标记,脚本和标记越积越多,最后资源耗尽卡死。
(2)“取消断点”为什么没用?
它关的是“你下的断点标记”,属于第一套机制。实测开启后仍然断 401 次,与基线一模一样。数字一点没变,说明那个开关根本没碰到这条路径。
(3)“忽略列表”为什么没用?
同理,它管的是“你的断点和单步是否进入某些脚本”,不改 debugger 语句的语义。实测同样是 401+。
(4)“掐定时器”为什么没用?三个独立原因,任意一个都足以致命
• 层次错了:你掐的是“每 4 秒重新点火”的备线,而卡你的是加载时已经开跑、靠 `recurse(++n)` 自驱动的递归;
• 赋值杀不掉已注册的定时器:定时器在页面加载时就注册进浏览器了,要取消必须 clearInterval(它的 id),而那个 id 藏在混淆代码的局部变量里,你拿不到。`window.setInterval = 空函数` 只影响“以后新注册的定时器”;
• 而且你按的“继续执行”本身就是在推进递归——看起来当然就像“掐了也没用”。
实测:掐掉后 10 秒仍断 437 次,基线 436 次——数字几乎一致。
(5)还有一个更硬的时序证据
页面加载后 1 秒内就断了 152 次,而定时器(0xfa0 = 4000 毫秒)第一次响是 4 秒。
在定时器还没响过一声之前,断点就爆了 152 次——这一条就足够证明:凶手不是定时器。
八、绕过实战:从 Console 一行到能反复用的脚本
8.1 思路:不打人,打他的“兵工厂”
前面把机制拆完,绕过思路其实就一句话:
既然它每一层都要在运行时编译一份 `debugger`,那就别让它有得编译。
不要去跟递归较劲(它自己会一直跑),也不要去跟定时器较劲(它只是备线),直接堵住“编译入口”。而这个站点的编译入口只有两个:
• Function('debugger') —— 直接调用;
• (function(){})['constructor']('debugger') —— 原型链调用(这个站点走的就是这条)。
对应的,我们要改的就是 window.Function 和 Function.prototype.constructor 这两个位置。
这个思路的好处是“降维”:不管它递归多少层、每层换个什么花样分支、每隔几秒重新点火,只要“编译”这一步被掐住,它后面所有动作全都变成空转。
8.2 最小可用版(Console 直接粘贴,用来验证思路)
先把最朴素的版本粘进 Console,确认思路成立:
(function () {
var Native = window.Function, NOOP = function () {}; // 存住原生 Function;准备一个公用空函数
function wrap(N) {
var F = function Function() { // 造一个“看起来一样”的 Function
var a = Array.prototype.slice.call(arguments);
if (!a.length) return N();
var last = a[a.length - 1];
if (typeof last === 'string') { // 只处理最后一个字符串参数(就是代码本体)
var c = last.replace(/debugger/gi, ''); // 把 debugger 抹掉
if (/^\s*$/.test(c)) return NOOP; // 抹完是空的 → 直接给空函数,不再编译
a[a.length - 1] = c;
}
return N.apply(this, a); // 其它情况照旧走原生
};
F.prototype = N.prototype;
return F;
}
var w = wrap(Native);
try { Object.defineProperty(window, 'Function', { value: w, writable: true, configurable: true }); } catch (e) { window.Function = w; }
try { Object.defineProperty(Function.prototype, 'constructor', { value: w, writable: true, configurable: true }); } catch (e) { Function.prototype.constructor = w; }
window.__patched = true;
})();
实测结果:暂停 436 → 0,空 URL 脚本 440 → 2,页面功能正常(标题正常渲染为“医保机构查询 - 国家医疗保障局”)。
⚠️ 两个注意点:
1. 粘贴完之后会再断 1 次(正在执行里的那一轮),按一次继续执行就干净了;
2. 千万别刷新——一刷新 JS 环境重建,补丁就没了。想让它扛住刷新,看下一节的油猴脚本。
8.3 正式版:完整油猴脚本(推荐日常使用)
上面那段每次都要手动粘,而且一刷新就失效。想一劳永逸,就把它做成油猴脚本。
完整代码如下(可以直接复制安装):
// ==UserScript==
// @name 无限 debugger 绕过(Function 编译入口)
// @namespace local.anti.debugger
// @version 1.2
// @description 绕过 javascript-obfuscator 的 debugProtection:Function(“debugger”) 每次生成新 VM
// @author local
// @match https://fuwu.nhsa.gov.cn/*
// @match http://fuwu.nhsa.gov.cn/*
// @run-at document-start
// @inject-into page
// @grant none
// ==/UserScript==
(function () {
'use strict';
var DEBUG = true; // 调试期开日志,确认生效后可以关掉
var NativeFunction = window.Function;
if (!NativeFunction || NativeFunction.__antiDebuggerWrapped) return; // 幂等:避免重复包装
var NOOP = function () {}; // 空函数只造一个,重复使用(后面解释为什么)
function sanitize(code) { // 清洗要编译的源码
if (typeof code !== 'string') return code;
return code
.replace(/debugger/gi, '')
.replace(/while\s*\(\s*true\s*\)\s*\{\s*\}/gi, '')
.replace(/for\s*\(\s*;\s*;\s*\)\s*\{\s*\}/gi, '');
}
function wrap(Native) {
var Wrapped = function Function() {
var args = Array.prototype.slice.call(arguments);
if (!args.length) return Native();
var last = args[args.length - 1]; // Function 的最后一个参数才是函数体
if (typeof last === 'string') {
var cleaned = sanitize(last);
if (/^\s*$/.test(cleaned)) { // 抹完是空的:给空函数,连编译都省了
if (DEBUG) console.log('[anti-debugger] 拦截一次编译:', JSON.stringify(last));
return NOOP;
}
args[args.length - 1] = cleaned;
}
return Native.apply(this, args);
};
Wrapped.prototype = Native.prototype; // ① 保持原型链
try {
Object.defineProperty(Wrapped, 'length', { value: Native.length });
Object.defineProperty(Wrapped, 'name', { value: 'Function' });
} catch (e) {}
// ② 反检测:让 String(我们的 Function) 仍然返回 [native code]
try {
var nativeToString = Function.prototype.toString;
Wrapped.toString = function () { return 'function Function() { [native code] }'; };
Wrapped.toString.toString = function () { return nativeToString.call(nativeToString); };
} catch (e) {}
Wrapped.__antiDebuggerWrapped = true;
return Wrapped;
}
var WrappedFunction = wrap(NativeFunction);
// ③ 堵两个入口:直接调用 + 原型链调用
try {
Object.defineProperty(window, 'Function', { value: WrappedFunction, writable: true, configurable: true });
} catch (e) { window.Function = WrappedFunction; }
try {
Object.defineProperty(Function.prototype, 'constructor', { value: WrappedFunction, writable: true, configurable: true });
} catch (e) { Function.prototype.constructor = WrappedFunction; }
// ④ 顺手把 eval 也收一下(有些混淆器改用 eval(“debugger”))
try {
var nativeEval = window.eval;
window.eval = function (code) {
if (typeof code === 'string') code = sanitize(code);
return nativeEval.call(this, code);
};
} catch (e) {}
if (DEBUG) console.log('%c[anti-debugger] Function 编译入口已在 document-start 挂上钩子',
'color:#0a0;font-weight:bold');
})();
8.4 Tampermonkey 配置:这一步配错,脚本就白装
这是最容易翻车的地方。脚本装上了、日志也打印了,但防护一点没变——九成是因为注入环境不对。
需要设置两处:
1. `@run-at document-start`(脚本头部已写)。意思是“在页面脚本之前跑”。太晚的话防护已经装好了,你再去改 Function 就来不及了。
2. `@inject-into page`(脚本头部已写,但 Tampermonkey 可能不认)。如果脚本里没生效,就手动改:
• Tampermonkey 面板 → 右上角设置 → 配置模式改成进阶;
• 找到注入模式 / Inject Mode,改成 instant 或 page;
• 不要用默认的 content(内容脚本)。
判断是否真的注入到页面主世界,用这一招:
在 Console 里执行:
Function.__antiDebuggerWrapped
• 返回 true → 注入成功,改到了页面的 Function;
• 返回 undefined → 你改的是隔离世界的 Function,页面的防护毫发无伤。这就是“脚本装了没用”的真相。
8.5 脚本原理逐条拆解(为什么必须这么写)
这部分是重点。看懂这几条,你以后自己写同类 Hook 都不会踩坑。
① 为什么要用 `Object.defineProperty`,而不是直接 `window.Function = xxx`?
因为 Function 在页面上可能被定义成不可写、不可配置的属性(有些平台会加固这一点)。直接赋值在严格模式下会静默失败或抛错:
// 危险写法:如果属性不可写,这一行什么都不会发生,你却以为成功了
window.Function = WrappedFunction;
所以用 defineProperty 显式指定 writable: true, configurable: true 强行覆盖,外面再包一层 try/catch,失败时退化成直接赋值——两条路都试,确保一定改到。
② 为什么两个入口都要堵?
因为 Function 和 Function.prototype.constructor 在 JS 里本来指向同一个对象,但页面可以用不同姿势拿到它,写法五花八门:
Function(“debugger”) // 直接调用
Function.constructor(“debugger”) // 属性访问
(function(){})[“constructor”](“debugger”) // 原型链——本站点的写法
[][“filter”][“constructor”](“debugger”) // 数组方法绕一圈
eval(“...”) // 换用 eval
只堵一个,另一个照样能用。 所以要 window.Function、Function.prototype.constructor 一起堵,eval 也顺手收一下。
③ 为什么“抹完是空的”要返回同一个 `NOOP`,而不是让它继续编译空字符串?
这是性能上的关键。回头看那段递归:它每层都调一次 Function(...),如果抹干净之后我们还老老实实去编译一个空函数,那么:
• 每次递归都真的编译一份新函数(编译是有成本的);
• 虽然不暂停了,但会在几毫秒内编译几千份空函数,CPU 直接起飞。
而返回一个共用的空函数,就变成“零成本通过”——不暂停、不编译、不占内存,递归很快触到栈溢出,被它自己的 try/catch 收掉,这一轮就安静结束了。
④ `Wrapped.prototype = Native.prototype` 是在防什么?
防检测。如果对方(或者某个库)用原型链判断“这个 Function 是不是原生的”,比如:
someFn.constructor.prototype === Function.prototype // 期望为 true
我们换掉 Function 之后如果不把 prototype 接回去,这一条就会变成 false,它就知道自己被 Hook 了,可能立刻触发 debugger,或者干脆换一套更狠的检测。所以包装函数一定要把原型链接回去,做到“行为上像原生的”。
⑤ 那段 `toString` 反检测是干什么的?
混淆器自带的 debugProtection 通常还有一个“自校验”动作:检查 `Function.prototype.toString` 是否被改过。
它的判断方式是看 toString 的结果里有没有 [native code]。如果我们包装过的 Function 被 String(...) 一下,输出的是我们那段包装代码(带 sanitize、Object.defineProperty 之类),一眼就露馅了。
所以补上:
Wrapped.toString = function () { return 'function Function() { [native code] }'; };
让它假装自己还是原生的。
补充一句我实测的情况:这个站点并没有检测 `Function` 本身(它的自校验只看自己内部那个函数的 toString),所以我上面那版最小实现(8.2)就已经 436 → 0 了。但换站点很可能就会遇到检测,所以正式脚本里把这一层加上,属于“有备无患”。
⑥ 幂等守卫 `if (NativeFunction.__antiDebuggerWrapped) return;` 有什么用?
防止重复包装。比如页面里还有别的脚本也做了同样的 Hook,或者你自己手滑粘了两遍,就会套成 Function → 包装 → 包装 的多层壳。层数多了,每次编译都要穿好几层,性能变差,而且 toString 特征更容易被识破。加个标记位,包装过就不再包装。
⑦ 为什么脚本里不管定时器?
因为没必要。前面已经证明:真正打你的是递归,递归不依赖定时器;而 Function 一被堵住,定时器每 4 秒拉起来的那一轮也只能空转。
改最少的东西,能达到目的就不要多改——改动越少,触发对方检测的概率越小。这是写 Hook 的一条准则。
8.6 通用版:换成别的站点也能用
上面那个脚本 @match 写死了本站点。如果你做的项目不止一个,可以用下面这个通用版——它不依赖任何函数名、也不依赖具体站点,只针对“Function 编译出 debugger”这个结构特征:
// ==UserScript==
// @name 通用无限 debugger 绕过(Function 编译入口)
// @namespace local.anti.debugger.generic
// @version 1.0
// @description 针对 javascript-obfuscator debugProtection 的通用绕过
// @author local
// @match *://*/*
// @run-at document-start
// @inject-into page
// @grant none
// ==/UserScript==
(function () {
'use strict';
var NativeFunction = window.Function;
if (!NativeFunction || NativeFunction.__wrapped) return;
var NOOP = function () {};
var PATTERNS = [
/debugger/gi, // 最直接的目标
/while\s*\(\s*true\s*\)\s*\{\s*\}/gi, // 死循环变体
/for\s*\(\s*;\s*;\s*\)\s*\{\s*\}/gi
];
function clean(code) {
if (typeof code !== 'string') return code;
var out = code;
for (var i = 0; i < PATTERNS.length; i++) out = out.replace(PATTERNS[i], '');
return out;
}
function wrap(Native) {
var W = function Function() {
var args = Array.prototype.slice.call(arguments);
if (!args.length) return Native();
var last = args[args.length - 1];
if (typeof last === 'string') {
var c = clean(last);
if (/^\s*$/.test(c)) return NOOP;
args[args.length - 1] = c;
}
return Native.apply(this, args);
};
W.prototype = Native.prototype;
try {
Object.defineProperty(W, 'length', { value: Native.length });
Object.defineProperty(W, 'name', { value: 'Function' });
W.toString = function () { return 'function Function() { [native code] }'; };
} catch (e) {}
W.__wrapped = true;
return W;
}
var WF = wrap(NativeFunction);
try { Object.defineProperty(window, 'Function', { value: WF, writable: true, configurable: true }); }
catch (e) { window.Function = WF; }
try { Object.defineProperty(Function.prototype, 'constructor', { value: WF, writable: true, configurable: true }); }
catch (e) { Function.prototype.constructor = WF; }
})();
通用版的取舍:@match *://*/* 意味着每个网站都会跑这个脚本。它做的事很轻(只包一层、不动别的),但毕竟改了所有页面的 Function。如果你只做某个项目,建议还是用 8.3 的专用版,把 `@match` 收窄到目标站点,更稳妥。
小技巧:写这类 Hook 时,先跑 8.2 的“探针版”(只统计不改行为)确认机制,再换成“清洗版”动手。先观测、后干预——这个顺序能让你少走很多弯路。
8.7 另外几条绕过路径(什么时候用哪个)
方案 |
适用场景 |
优点 |
代价 / 风险 |
一律不在此处暂停 |
那种最老实的、源码里写死 debugger 的站点 |
零成本,一键 |
对动态编译无效;用久了资源堆积会卡死 |
Console 粘补丁 |
临时看一眼、验证思路 |
几秒钟搞定 |
一刷新就失效 |
油猴脚本(本文推荐) |
长期做同一个站点的项目 |
一劳永逸,自动生效 |
需要正确配置注入模式;跨站点要单独配 @match |
DevTools 本地覆盖(Overrides) |
需要长期改源码、还想保留自己下断点的能力 |
改的是源码本身,最“干净”,不受 Hook 检测影响 |
要手动定位并删掉混淆代码;站点改版后要重做 |
代理/中间人替换 JS |
抓包工具顺手就能改,或者需要自动化 |
与浏览器环境无关,脚本注入类检测抓不到 |
要维护替换规则;代码更新后规则会失效 |
为什么我把油猴脚本放在第一位? 因为它成本最低、可复用、且不依赖站点代码的具体位置——站点改个混淆版本、函数名全变,这个脚本照样有效,因为它堵的是“编译入口”这个不变的点。
8.8 怎么确认真的绕过了
别只看“这次没断”,按下面两条一起验:
1. 暂停计数归零:刷新后打开 DevTools,等 15 秒,看 Sources 里是否还在不断冒出新的 VM 文件。不冒了,才算真过;
2. 页面功能正常:标题、路由、接口请求都正常(比如这个站点标题应该是“医保机构查询 - 国家医疗保障局”),控制台没有新的报错。
两条都满足才算过。 只满足第一条有可能是你把页面 hook 坏了(防护和业务一起被你打死了),这种“绕过”没有意义。
顺带一提:页面初始化时本来就会用 Function 编译一些正常业务函数(Vue 这类框架干得不少),所以“空 URL 脚本数”不会降到 0,会剩下几个。它降到 0 反而说明你把页面搞坏了。 真正要看的指标只有一个:暂停次数。
我按第八节这份正式脚本(8.3)实测的完整结果:
指标 |
结果 |
注入前 1 秒内暂停 |
0 |
之后 15 秒暂停 |
0 |
Function.__antiDebuggerWrapped |
true(说明改到的是页面主世界的 Function) |
String(window.Function) |
function Function() { [native code] }(反检测伪装生效) |
页面标题 / 状态 |
医保机构查询 - 国家医疗保障局 \ |
页面正常 + 暂停归零 + 伪装有效,三条都拿到了。
九、两个必须知道的坑
9.1 在控制台打完补丁,千万别刷新
如果你是页面已经加载完之后才在控制台贴补丁,你会看到“还会再断 1 次”,然后彻底干净(实测:补丁后 13 秒内只断 1 次,跨过 3 个定时器周期,之后全是 0)。
• 那 1 次是正在执行里的那一轮,按一次继续执行放过去就行;
• 但千万别刷新——一刷新整个 JS 环境重建,补丁没了,防护重新装上。
这不是补丁没用,是刷新的问题。 我一开始就是在这里误判的:打完补丁发现“还是断”,一怒之下刷新,结果更绝望。
9.2 为什么“装了脚本却没效果”——隔离世界
这个坑值得单独说一遍,因为它太常见了:脚本装上了、日志也打印了、看起来一切正常,但防护一点没变。
原因在于 Tampermonkey 默认把脚本注入隔离世界(isolated world):
• 页面主世界(page world):页面自己的 JS 跑在这里,window、Function、Array 都是这一份;
• 隔离世界(isolated world):油猴脚本所在的世界,它有自己的 `window`、自己的 `Function`,和页面主世界是两套。
后果就是:你在隔离世界里把 Function 改成了自己的包装函数,改得再漂亮,页面主世界里的那个 `Function` 纹丝不动——防护当然一点没变。
判断方法(前面 8.4 提过,这里再强调一次):
// 在 Console 里执行(Console 默认在页面主世界)
Function.__antiDebuggerWrapped
• true → 改到了页面主世界的 Function,脚本生效;
• undefined → 你改的是隔离世界,没生效,去把注入模式改成 page / instant。
这也顺便解释了一个现象:为什么很多“通用无限 debugger 绕过脚本”看起来写得很专业、评论区也有人说好用,在你这个站点上却完全没用——因为它们的 Hook 打在了错误的那个世界里。
对照一下前面第八节的脚本头部:
// @run-at document-start
// @inject-into page
这两行不是装饰,是能不能生效的前提。
十、可复用的分析流程(下次直接照做)
第 1 步:先分清“谁在暂停你”——看三样东西
• 脚本源码文本:出现 function anonymous( 这种外壳 → 是运行时编译出来的;
• 脚本 URL:空 / 无来源 → 不是网络加载的;
• scriptId 是否每次都变:每次全新 → 代码在被反复重新编译。
第 2 步:再看“谁在制造它”——读调用栈
同一个函数名重复 N 层 = 递归;N 随暂停次数增长 = “继续执行”就是“深入一层”。
第 3 步:找“谁在点火”——全局搜索
关键词:setInterval(、setTimeout(、constructor']('、debu。注意字符串数组混淆的特点:`'debu'` 和 `'gger'` 会在同一个字符串数组里相邻。
第 4 步:跟着栈名定位到具体文件
栈里看到什么名字就搜什么名字,命中的那个 bundle 就是作案现场。
第 5 步:仪表化——把黑盒变白盒(最省力的路)
// 只统计、不改行为:看谁在调用编译器、编译了什么
(function(){
var N = window.Function;
window.__n = 0; window.__calls = [];
var W = function(){
var a = [].slice.call(arguments);
window.__n++;
if (window.__calls.length < 4) window.__calls.push(String(a[a.length-1]));
return N.apply(this, a);
};
W.prototype = N.prototype;
try { Object.defineProperty(window,'Function',{value:W,writable:true,configurable:true}); } catch(e) { window.Function = W; }
try { Object.defineProperty(Function.prototype,'constructor',{value:W,writable:true,configurable:true}); } catch(e) { Function.prototype.constructor = W; }
})();
等几秒后读取:
window.__n // → 592(Function 被调用了几百次)
window.__calls // → ["debugger","debugger","debugger","debugger"]
谁在编译、编译了什么,一目了然——一行混淆代码都不用读。
第 6 步:干预 + 证伪
堵住编译入口,然后确认暂停次数归零、页面功能正常。能被证伪、而且真的证伪了,才叫定位完成。
十一、两个实验设计上的坑(我自己踩过)
写这类分析时,有两个陷阱会让你的数据自相矛盾,甚至得出反向结论:
坑 1:只改 hash 的“同 URL 导航”不会重新加载文档。
这个站是 hash 路由(#/search/...),你“重新导航”到同一个 URL,浏览器会认为只是锚点变化,不会重新加载页面。于是你的实验会互相污染,数据看起来莫名其妙。结论:每个实验用全新标签页。
坑 2:“自动继续执行”和“停在原地”是两种完全不同的实验语义。
混用会得出相反结论。要测“你总共得按多少次继续”,就自动继续;要测“停住的时候世界长什么样”,就停在原地。
十二、总结
这个站点的无限 debugger,其实由三段拼起来:
1. 字符串数组混淆:把 debugger、constructor 拆成下标存放,躲开关键词搜索('debu' 和 'gger' 相邻摆着);
2. 递归函数:每层执行一次 Function('debugger')('action'),产生一份全新的编译产物(所以每次都是新 VM);靠 _0x51030e(++n) 自我增殖;栈溢出被 try/catch 吞掉,所以永远不会自己停;
3. 定时器每 4 秒重新点火:setInterval(function(){...}, 0xfa0)——它只是备线,不是主线。
对应的三句话结论:
• `debugger` 是“代码找调试器”,跟“你下没下断点”无关 → 取消断点、忽略列表全都无效;
• 递归是自调用,不依赖定时器 → 掐定时器影响不到你眼前这一轮;
• 已注册的定时器赋值杀不掉,要 `clearInterval(id)` → 那个赋值连备线都没真正掐断。
唯一有效的手段:堵住编译入口 `Function` / `Function.prototype.constructor`(实测 436 → 0)。
对应的成品脚本在第八节,两个版本各有用处:
• 8.3 专用版:@match 收窄到目标站点,日常做项目用这个;
• 8.6 通用版:不写死站点和函数名,靠“编译入口”这个结构特征生效,换站点也能用。
用之前务必确认 8.4 那两处配置(document-start + 注入到页面主世界),否则脚本等于没装。
最后用一句话记住整件事:
`setInterval` 是每 4 秒来叫醒闹钟的那只手,递归才是持续打你的拳头,而 `Function(“debugger”)` 是拳头的制造机。你按住了手,拳头还在打——真正该拆的,是那台制造机。